Slotted Page·B+Tree·Buffer Pool을 거쳐 디스크의 행을 읽고 쓰는 C11 데이터베이스.
- 역할
- 팀 과제 · 개인 확장 종료
- 기간
- 2026-04-16 ~ 2026-09-22
SQL 한 문장을 파싱해 실행 계획을 세우고, Slotted Page·B+Tree·Buffer Pool을 거쳐 디스크의 행을 직접 읽고 쓰는 C11 데이터베이스입니다. “DB가 안에서 무슨 일을 하는가”를 라이브러리 없이 끝까지 구현해 보려고 만들었습니다.
버전업된 모습
처음 만든 엔진은 10,000행 기준으로는 멀쩡해 보였습니다. “시료가 작다”는 지적을 받고 규모를 1,000,000행으로 올리자 INSERT가 무너졌습니다. 삽입 시간이 50k → 0.25초, 100k → 0.96초, 200k → 4.73초 — 행 수가 2배가 될 때마다 시간이 4배, O(N²)의 서명이었습니다.
원인을 눈으로 못 찾아서 실행 중인 삽입 프로세스에 gdb를 붙여 스택을 샘플링했고, 그제서야 결함 2건이 잡혔습니다. 하나는 꼬리 페이지가 찰 때마다(약 90행마다) 삭제 슬롯 재활용을 위해 DELETE가 한 번도 없었는데도 힙 체인 전체를 처음부터 다시 걷던 find_heap_page였습니다. 다른 하나는 서버 경로(db.c)는 문장 종료 시 lock을 풀지만 REPL 경로(main.c)만 lock_release_all()을 빠뜨려 X-lock 엔트리가 lock 테이블에 영구 누적되던 것이었습니다. 스택 샘플 4회 중 4회가 그 해시 체인 탐색 위에 있었습니다. 두 번째 결함은 같은 autocommit 의미론을 두 경로에 따로 구현해 둔 탓이라, 성능 문제로 위장한 정확성 버그였다는 점이 뼈아팠습니다.
빈 슬롯 힌트(heap_may_have_free_slots)와 REPL의 Strict 2PL 준수로 고쳤습니다. 별도로 범위 질의가 id 조건에서도 힙을 전부 훑던 것을 B+Tree 리프 순회(INDEX_RANGE)로 바꿨습니다.
증거는 배수가 아니라 기울기로 남깁니다
처음에는 “×215 빨라졌다”고 적었습니다. 그런데 같은 스크립트를 다시 돌릴 때마다 ×57, ×107 로 값이 흔들렸습니다. 절대 배수는 캐시 크기와 메모리 대역폭을 따라 움직이는 숫자라, 다른 기계에서 재현되지 않습니다.
대신 행 수가 2배가 될 때 시간이 몇 배가 되는가를 봅니다. 이건 알고리즘의 성질이라 기계가 바뀌어도 남습니다. 4에 가까우면 O(N²), 2에 가까우면 O(N)입니다.
| 행 수 | 개선 전 INSERT | 배가 계수 | 개선 후 INSERT | 배가 계수 |
|---|---|---|---|---|
| 50,000 | 0.106s | — | 0.060s | — |
| 100,000 | 0.400s | 3.76x | 0.121s | 2.01x |
| 200,000 | 1.683s | 4.21x | 0.240s | 1.98x |
| 400,000 | 7.412s | 4.40x | 0.480s | 2.00x |
| 행 수 | Range — 힙 스캔 | 배가 계수 | Range — B+Tree 인덱스 | 배가 계수 |
|---|---|---|---|---|
| 50,000 | 0.051s | — | 0.023s | — |
| 100,000 | 0.079s | 1.54x | 0.024s | 1.05x |
| 200,000 | 0.143s | 1.81x | 0.024s | 1.00x |
| 400,000 | 0.335s | 2.33x | 0.025s | 1.05x |
make bench로 약 1분에 다시 냅니다. “개선 전”은 수정 커밋 993d4d8의 직전 코드를 git archive로 되살려 같은 컴파일러로 빌드한 것이고, “힙 스캔”은 현재 소스를 -DMINIDB_DISABLE_INDEX_RANGE로 빌드한 것입니다. Range는 반환 행 수가 1,000으로 고정이므로, 시간이 N을 따라 늘면 접근 경로가 테이블 크기에 비례한다는 뜻입니다.1
단일 규모의 절대 수치가 필요하면 make bench-1m입니다. 이 저장소에서 마지막으로 잰 값은 1M 행 기준 INSERT 632,962 ops/sec, Range 3,267 ops/sec(힙 스캔 108 ops/sec)입니다(2026-09-22, Apple M4, -O2, median of 3).
정직하게 덧붙이면, 개선 후 수치가 PostgreSQL(1M INSERT fsync=off 10,919 ops/sec)보다 높은 것은 성능 우위가 아닙니다. 이 엔진은 WAL이 없어 dirty 페이지를 캐시 축출·종료 시에만 디스크로 내리므로 내구성 조건이 다릅니다. 같은 조건의 성능 비교로 읽으면 안 됩니다.2
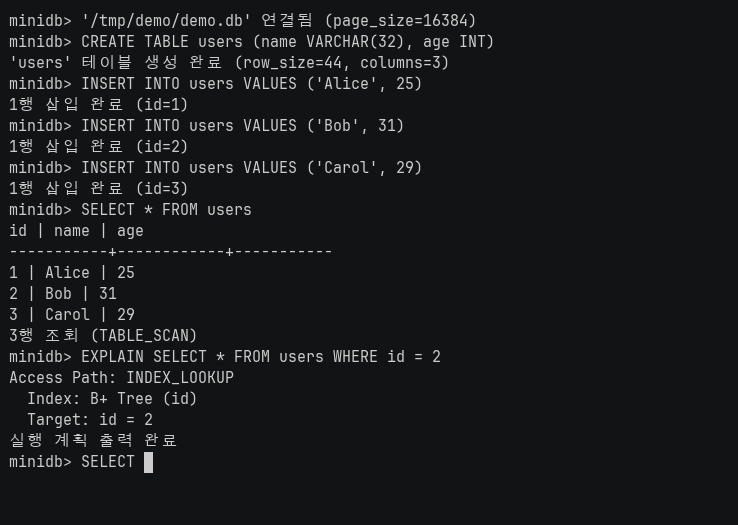
구동모습
테이블 생성 → INSERT 1,000건 → 건수 확인과 범위 SELECT를 파이프 입력으로 실행한 실제 출력입니다. INSERT 1,000건 전체에 0.010s(time), 범위 SELECT는 INDEX_RANGE 경로로 0.02ms(.debug 출력)가 걸렸습니다. 데모 빌드는 sanitizer 없는 -O2(SANITIZE=)이며 재현은 bash scripts/demo_repl.sh입니다.

메인 기술
- Slotted Page 힙 — 페이지 안에 slot directory를 두고 삭제된 slot을 재사용합니다. 고정
row_size직렬화. →src/storage/table.c - B+Tree 점 조회와 범위 스캔 — 분할·삭제를 처리하고, 리프의
next_leaf_page_id형제 포인터를 따라 오름차순 순회합니다. 리프 이동은 다음 리프 rlatch를 먼저 잡고 현재를 해제하는 leaf-chain latch coupling입니다. →src/storage/bptree.c - 규칙 기반 planner —
id점 조건은INDEX_LOOKUP,id범위 조건(BETWEEN,>=,<)은INDEX_RANGE, 그 밖은TABLE_SCAN으로 접근 경로를 고릅니다. 비용 기반이 아닌 규칙 기반입니다. →src/sql/planner.c - pin·dirty·LRU Buffer Pool — 256개 frame을 관리하며 pin된 페이지는 교체 대상에서 제외합니다. →
src/storage/pager.c - Strict 2PL 행·범위 lock — S/X lock 호환성과 범위 lock으로 phantom insert를 막고, 문장 종료 시 전부 해제하는 autocommit 경로입니다. →
src/server/lock_table.c - 재현용 컴파일 가드 —
-DMINIDB_DISABLE_INDEX_RANGE,-DMINIDB_DISABLE_FREE_HINT로 개선 전 동작을 그대로 빌드해 전/후를 같은 바이너리 계열에서 비교합니다.
왜 이 자료구조를 골랐고 무엇을 버렸는지, 지금 어디가 비어 있는지는 docs/design.md에 적었습니다 — 버린 대안(밀집 배열 힙, 인덱스 구성 테이블, 해시 인덱스, 정렬 배열)과 그 이유, property test가 닿지 못하는 경로, 다음에 무너질 지점까지.
계획
- WAL을 넣어 갑작스러운 중단에서의 crash recovery를 검증한다. 지금은 정상 종료 후 재열기만 보장한다.
- secondary index를 추가하면 planner를 규칙 기반에서 선택도 기반 비용 모델로 바꾼다.
- 여러 문장을 묶는 명시적 트랜잭션(
BEGIN/COMMIT)을 지원하면 지금의 문장 단위 Strict 2PL을 트랜잭션 단위로 확장한다. - 1M을 넘는 규모에서 DB 파일이 페이지 캐시를 벗어나면(현재 1M ≈ 52MB) 디스크가 실제 병목인 구간을 다시 측정한다.
링크
- SQL 엔진 구현 Wiki
- 설계 노트 — 무엇을 고르고 무엇을 버렸나
- 설계 문서 목차
- PostgreSQL 대조 실험 전문
- 팀 원본 저장소 (Jungle-12-303/wk08_1)
- CI 실행 기록
담당
크래프톤 정글 팀 과제(원본: Jungle-12-303/wk08_1)에서 시작했고, 종료 후 개인 저장소에서 계속 수정·학습·확장하고 있습니다.
| 항목 | 내용 |
|---|---|
| 원본 팀 저장소 | Jungle-12-303/wk08_1 |
| 팀 과제 기간 | 2026-04-16 ~ 2026-05-08 (커밋 40327ef ~ e5d7238). 다른 팀원의 마지막 커밋은 2026-04-22 |
| 팀 구성 | 5인. main 에 병합된 기여자는 4인(최우녕·정범진·이호준·최현진)이고, 나머지 1인의 커밋은 병합되지 않은 브랜치에 남아 있다 — git shortlog -sne --all 로 확인 |
| 본인 담당 | 저장소 전반의 엔진 코드(parser·planner·executor·pager·bptree·table·lock_table)를 개인 주도로 대부분 직접 구현 |
팀 코드 전체를 개인 구현으로 주장하지 않습니다. 팀 기간의 기여 구분은 원본 저장소의 커밋 저자와 파일별 diff로 확인합니다.
개인 확장 (팀 과제 종료 후)
커밋 범위: 369fb58 (2026-08-01) ~ bfc27a9 (2026-09-11), 11개 커밋. git log --author 기준입니다.3
| 무엇이 달라졌나 | 커밋 | 파일 |
|---|---|---|
B+Tree 인덱스 범위 스캔(INDEX_RANGE) 추가 — BETWEEN·부등호 파싱, 접근 경로, 리프 순회 | c1049b0 | bptree.c, parser.c, planner.c, executor.c |
| 1M 행 INSERT의 O(N²) 결함 2건 수정 — 힙 재탐색 힌트, REPL lock 해제 누락 | 993d4d8 | table.c, pager.c, main.c, executor.c |
| sanitizer 선택 빌드(ASAN/UBSAN)와 224개 테스트를 묶는 CI 게이트 도입 | 7b7c43f, 3651a8d | Makefile, .github/workflows/ci.yml |
| 저장소 정리 — 빌드 산출물·Python 캐시·작업용 스테이징 폴더 제거 | b169446, eeaa0ab | .gitignore 외 |
| 문서 — 저장 구조 선택 근거, 실행 방법, 출처·기여 경계 명시 | 369fb58, bd0d068, 913de5c, bfc27a9 | README.md, docs/ |
팀 과제 종료 시점(e5d7238) 대비 엔진 코드 순증은 src/ 기준 +388/-2행입니다(git diff --stat e5d7238 HEAD -- src/).
구동방법
GCC, Make, pthread가 필요합니다. Linux는 저장소의 Dev Container 설정을 쓸 수 있습니다.
git clone https://github.com/woonyong-choi/lrn-sql.git
cd lrn-sql
make
./build/minidb demo.db
새 DB의 REPL에서 다음을 한 줄씩 입력합니다.
CREATE TABLE users (name VARCHAR(32), age INT)
INSERT INTO users VALUES ('Alice', 25)
SELECT * FROM users
EXPLAIN SELECT * FROM users WHERE id = 1
SELECT * FROM users WHERE id = 1
1 | Alice | 25가 나오고 INDEX_LOOKUP 계획을 확인할 수 있습니다. .stats는 페이지·트리 통계, .debug는 쿼리별 페이지 접근, .btree는 인덱스 구조를 보여 줍니다. .exit 또는 Ctrl-D로 종료하면 dirty 페이지를 기록합니다.
기본 빌드는 ASAN·UBSAN을 켭니다. CI(Ubuntu)는 이 빌드로 전 테스트를 돌립니다.
macOS 26(Darwin 25) + Apple clang 17에서는 ASan 바이너리가 main()에 닿기 전에 멈춥니다. lrn-sql의 문제가 아니라 ASan 런타임 초기화가 자기 자신을 재진입하는 것으로, int main(void){return 0;} 한 줄을 cc -fsanitize=address로 빌드해도 똑같이 멈춥니다. 스택은 AsanInitInternal → InitializeShadowMemory → get_dyld_hdr → dyld_shared_cache_iterate_text_swift → malloc → __sanitizer_mz_malloc → 다시 AsanInitFromRtl로 들어가 spin lock에 걸립니다. UBSan 단독은 정상 동작합니다.
# macOS: UBSan 만 켜기 (ASan 대신은 아닙니다)
make BUILD_DIR=build-ubsan SANITIZE=undefined test-all

# sanitizer 없이
make BUILD_DIR=build-nosan SANITIZE= all
./build-nosan/minidb demo.db
설계 문서는 docs/README.md를 참조합니다.
스펙
| 구분 | 내용 |
|---|---|
| 언어 | C11 (-Wall -Wextra -Werror) |
| 빌드 | GNU Make, GCC |
| 런타임 의존성 | POSIX pthread만 사용. 외부 DB·파서·인덱스 라이브러리 없음 |
| 진단 도구 | AddressSanitizer, UndefinedBehaviorSanitizer, gdb(스택 샘플링) |
| 서버 경로 | 자체 HTTP 처리(keep-alive, 요청 읽기 타임아웃) |
| 벤치마크 하니스 | Python 3 + psycopg2 (bench/), 대조군 PostgreSQL 16.13 |
검증

make test-all은 저장 구조·SQL·동시 요청을 검사합니다. 510개 전부 통과합니다(2026-09-22 로컬 재실행).4
| 스위트 | 통과 | 대상 |
|---|---|---|
| MiniDB Test Suite | 76/76 | 페이지·힙·B+Tree·재열기 |
| B+Tree Property | 215/215 | 무작위 삽입·삭제 후 구조 불변식 8종, 범위 스캔 대조 |
Step 0 — db_execute | 24/24 | 문장 실행 진입점 |
| Step 1 — SQL Extension | 143/143 | 파싱·계획·조건·정렬·집계·INDEX_RANGE·EXPLAIN 일치 |
| Step 2 — Concurrency | 52/52 | S/X lock 호환성, 범위 lock, 동시 INSERT, HTTP 경로 |
| 합계 | 510/510 |
B+Tree는 오름차순 삽입만으로는 검증되지 않습니다. 그 모양은 리프가 오른쪽으로만 쪼개지는 한 가지 경우일 뿐이라, 형제 재분배와 병합이 섞이는 삭제 경로를 밟지 못합니다. Property 스위트는 고정 시드 난수로 삽입·삭제를 섞어 돌리며 체크포인트마다 트리 전체를 걸어 리프 깊이 일치·키 순증가·부모 separator 구간·최소 점유율·리프 체인 대칭·페이지 중복 없음·parent_page_id 정합·참조 모델 일치를 봅니다. 이 검사가 껍데기가 아닌지는 결함 5종(불균형 분할, separator 오프바이원, 리프 체인 끊김, 언더플로우 복구 비활성화, 범위 경계 제외 누락)을 일부러 심어 확인했고 전부 서로 다른 불변식에 걸렸습니다. 자세한 것은 docs/design.md §5.
make test-all      # 510개 검사 (CI와 동일)
make bench         # 규모별 기울기 재측정 (약 1분)
make bench-1m      # 1M 행 단일 규모
python3 bench/bench_pg_param.py --rows 1000000 --reps-insert 1   # PostgreSQL 대조군
CI는 GitHub Actions에서 ASAN_OPTIONS=detect_leaks=1, UBSAN_OPTIONS=halt_on_error=1로 make test-all을 실행합니다.
현재 범위
단일 테이블과 자동 생성 id 인덱스를 중심으로 CREATE·INSERT·SELECT·UPDATE·DELETE·DROP과 일부 조건·정렬·집계를 지원합니다. secondary index, 비용 기반 optimizer, 여러 문장을 묶는 트랜잭션, WAL crash recovery는 없습니다. 정상 종료 후 재열기는 보장하지만 갑작스러운 중단에서의 복구는 범위 밖입니다.
참고자료
- PostgreSQL 대조 실험 전문 — 측정 조건·결함 진단·정직한 평가
- 팀 원본 저장소 Jungle-12-303/wk08_1
- Database Internals (Alex Petrov) — Slotted Page·B+Tree 구조
- PostgreSQL 16 문서 — 대조군 설정(
synchronous_commit,fsync)
-
make bench(=python3 bench/scaling.py). 전체 표는bench/scaling.md, 그래프는make bench가 다시 그립니다. 규모별 3회 중앙값, 프로세스 기동 시간은 no-op 실행으로 차감. ↩ -
측정 조건·결함 진단·재현 명령은
docs/benchmark-postgres.md9절(“규모를 키우니 다른 곳이 무너졌다”). 1M 행 median of 3. ↩ -
make BUILD_DIR=build-nosan SANITIZE= test-all출력의 스위트별 합계. ↩
이 페이지의 본문은 woonyong-choi/lrn-sql 의 README(커밋 7f6cb84)를 그대로 옮긴 것입니다. 프로젝트 목록으로