NumPy만으로 MLP·역전파·Adam을 구현한 손글씨 숫자 분류기. 테스트 정확도 97.80%.
- 역할
- 3인 팀 과제 · 개인 확장 진행 중
- 기간
- 2026-05-13 ~ 2026-09-22
손글씨 숫자 하나를 0~9로 분류하는 NumPy 신경망입니다. 프레임워크 없이 MLP·역전파·BatchNorm·Dropout·Adam을 직접 구현하고, 이미지 파일이나 브라우저 캔버스에 그린 숫자를 판별합니다. 포함된 모델의 MNIST 테스트 정확도는 97.80%이고, make bench로 다시 학습하면 models/reference.npz와 가중치가 비트 단위로 같습니다.
크래프톤 정글 팀 과제(원본: Jungle-12-303/wk13_6_mnist, 비공개)에서 시작했고, 종료 후 개인 저장소에서 계속 수정·학습·확장하고 있다. 3인 팀, 본인 커밋 12개. 자세한 내용은 내 기여·출처.
딥러닝 Wiki · 설계 노트 · 벤치마크 · 모델·혼동행렬·학습 조건
데모 (구동모습)

make demo 후 make serve → http://127.0.0.1:8765 에서 캔버스에 7과 3을 마우스로 그리고 판별한 화면입니다. 제공 모델(models/reference.npz)의 실제 출력이며 두 경우 모두 해당 숫자가 100.0%로 표시됐습니다. 예시로 고른 두 장이므로 정확도를 뜻하지 않고, 점수는 보정된 confidence가 아닙니다. 모델 정확도는 manifest를 봅니다.
문제와 목표
MNIST는 이미 잘 풀린 문제라서 정확도 숫자 자체보다 직접 구현한 신경망이 맞게 동작한다는 증거와 숫자를 믿을 수 있게 만드는 평가 방식이 과제의 핵심입니다.
- 목표 1: Affine·ReLU·BatchNorm·Dropout·Softmax+Cross Entropy와 그 backward, SGD·Adam을 NumPy만으로 구현하고, 수치 미분으로 gradient가 맞는지 확인한다.
- 목표 2: 테스트 데이터를 모델 선택에 쓰지 않는 평가(train/validation/test 분리)를 한다.
- 목표 3: 학습한 모델을 저장·복원해 이미지 파일과 손그림 화면으로 실제 입력을 판별한다.
- 비목표: CNN, OCR, 여러 자리 숫자 인식.
결과
| 지표 | 값 | 비고 |
|---|---|---|
| 테스트 정확도 | 97.80% (9,780 / 10,000) | 모델 선택에 쓰지 않은 공식 test 10,000장 |
| 검증 정확도 | 97.84% | 선택에 쓴 validation 10,000장 |
| 재학습 결과 | 가중치 비트 단위 일치 | seed 42로 다시 학습한 모델이 models/reference.npz와 동일 (bench) |
| 학습 시간 | 8 epoch에 8초 안팎 (epoch당 약 1초) | Apple M4, BLAS 스레드 1개. 기계 부하에 따라 흔들려 make bench가 epoch별 시간과 측정 시각을 함께 남깁니다 |
| 추론 처리량 | 초당 20~30만 장 (batch ≥ 1,024) / 2만 장 (batch 1) | 같은 행렬곱만 돌린 하한이 전체의 절반을 못 넘습니다 — 병목은 원소 연산 (bench) |
| 모델 파일 | 847,725 바이트 | models/reference.npz |
| 오분류 | 220장 | 가장 많은 혼동: 7→2 13회, 4→9 12회, 9→4 12회 |
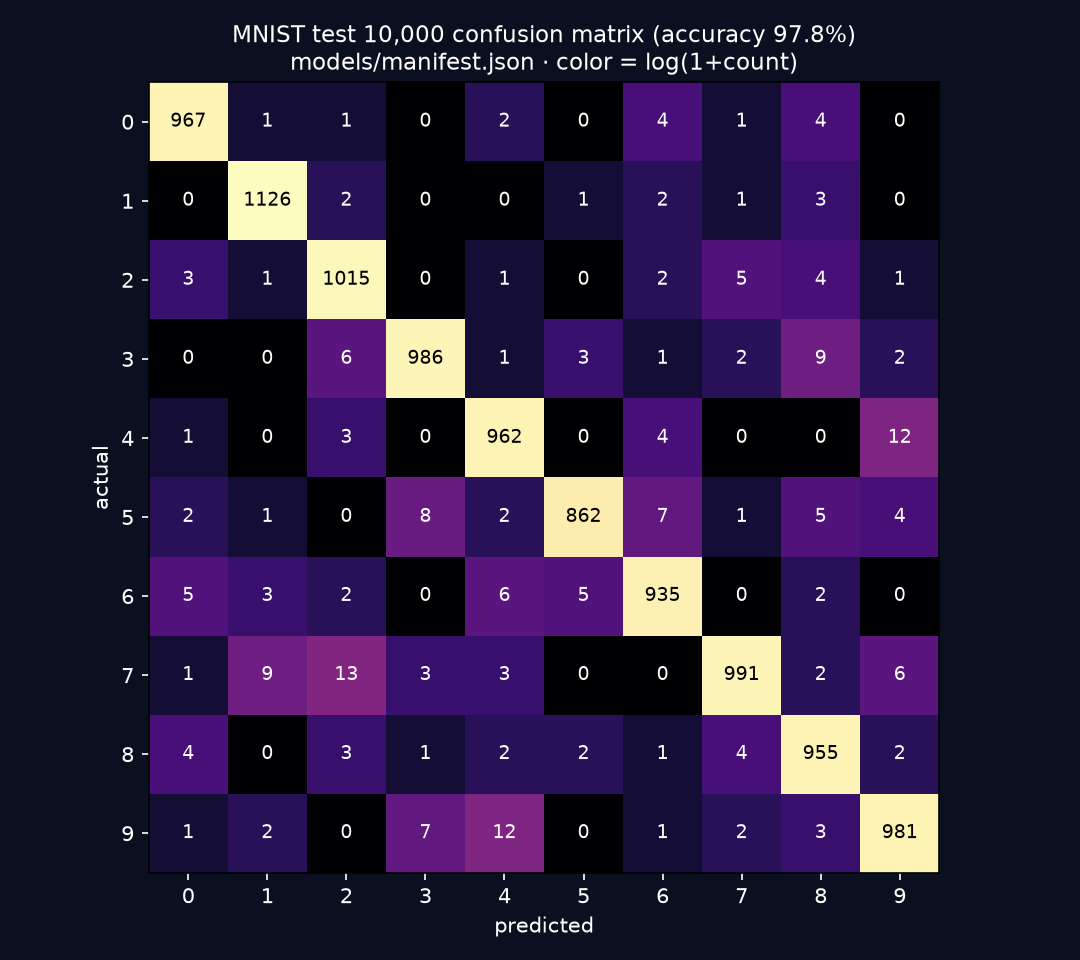
혼동행렬은 models/manifest.json의 evaluation.confusion_matrix 수치를 그대로 그렸습니다(행 합계 = 테스트 10,000장).
재현: make setup && make evaluate(공개 MNIST 약 11 MiB를 내려받고 sha256을 manifest 기록값과 대조함)가 test 정확도 0.978과 모델 sha256(bcbcbdeb…)을 manifest와 같게 출력합니다. 한 걸음 더 들어가 make bench는 같은 seed로 다시 학습한 가중치가 포함된 모델과 비트 단위로 같은지까지 매번 확인합니다 — “재현 가능”을 문서 문장이 아니라 실행 결과로 두기 위해서입니다. 학습 환경은 manifest에 기록돼 있습니다(Python 3.12.12, NumPy 2.5.3, seed 42).
팀 과제 시점의 수치(98.54%)와 직접 비교하지 마세요. 팀 보고서의 최종 모델은 은닉층 [512, 256]·Dropout 0.5·학습 데이터 60,000개이고, 테스트 정확도가 가장 높은 설정을 골랐습니다(REPORT.md@6a7e451). 이 저장소는 모델도 평가 방식도 다르며, 테스트를 선택에 쓰지 않은 97.80%가 정직한 추정치입니다.
실행 방법
Python 3.12와 uv가 필요합니다. 의존성은 requirements.lock으로 고정합니다.
make setup
make demo
make serve
# 브라우저: http://127.0.0.1:8765
데모와 손그림 화면은 포함된 모델을 사용하므로 MNIST 다운로드나 재학습이 필요 없습니다. 예측 숫자·클래스별 점수와 실제 모델에 입력된 28×28 이미지를 확인합니다. 서버는 Ctrl-C로 종료합니다.
make test
make bench   # 재현성·학습 시간·추론 처리량을 다시 측정 (약 15초)
.venv/bin/python src/application.py predict examples/digit-7.png
# 새 모델 학습은 별도 실행: 제공 모델을 덮어쓰지 않음
make train
.venv/bin/python src/application.py evaluate --model .artifacts/model.npz --output .artifacts/my-evaluation/metrics.json
설계
이미지 반전·crop·비율 유지·중심 정렬 → 28×28 입력 → MLP → 클래스별 점수로 이어집니다. 왜 이 구현인지, 무엇을 버렸는지, 무엇이 아직 틀렸는지는 설계 노트에 따로 적었습니다.
모델 구성 (network.py, layers.py)
784 → Affine(128) → BatchNorm → ReLU → Dropout(0.1)
    → Affine(64)  → BatchNorm → ReLU → Dropout(0.1)
    → Affine(10)  → Softmax + Cross Entropy
- 초기화: 가중치는 He 초기화(
randn * sqrt(2 / fan_in), ReLU에 맞는 분산), bias는 0, BatchNorm의 γ는 1·β는 0입니다. - 학습 설정: Adam(lr 0.001), batch 128, 8 epoch, seed 42. MNIST training 60,000개를 seed 42로 train 50,000 / validation 10,000으로 나누고, validation 정확도가 가장 높은 epoch의 모델을 씁니다. 공식 test 10,000개는 선택에 쓰지 않습니다.
- 왜 이 설정인가: 팀 실험에서 은닉층을 [1024, 512]로 키워도 같은 98.54%에 파라미터·시간만 늘었고 [5120]도 비용 대비 이득이 제한적이었으며, Adam은 SGD보다 결과 변화 폭이 작았습니다(보고서 §5). 이 저장소는 그 결과를 바탕으로 5초 안에 재학습되는 작은 구성을 기준으로 삼았습니다. Dropout을 0.5에서 0.1로 낮춘 것의 단독 효과는 측정하지 않았습니다.
- 트레이드오프: 작은 MLP는 빠르고 모델이 0.8 MB지만, 손그림처럼 MNIST와 굵기·위치가 다른 입력에 약합니다.
모듈 경계 — 파일 하나가 한 가지 일만 합니다.
| 모듈 | 하는 일 |
|---|---|
| layers · activations · losses · optimizers | 층·활성화·손실·갱신 규칙의 forward/backward |
| network | 층을 쌓고 params/grads 를 관리 |
| data | MNIST 다운로드·sha256 검증·정규화 |
| training | train/validation 분할, 학습 루프, 평가 |
| checkpoint | .npz 저장·복원과 로드 시 검증 |
| images | 이미지 전처리와 한 장 판별 |
| serving | loopback 추론 서버 |
| application | 명령줄 배선만 (78줄) |
입출력 (images.py, checkpoint.py, web/index.html)
- 전처리는 배경이 밝으면 색을 반전하고, 숫자 영역을 잘라 긴 변을 20px로 맞춘 뒤 28×28 캔버스 중앙에 붙입니다(MNIST 규약). 빈 입력은 거절하고 전처리 결과를 화면에 보여 줍니다.
- 모델은 weights와 BatchNorm 통계를 NumPy 배열(
.npz)로 저장하며 pickle을 쓰지 않습니다. 복원할 때 shape·유한성·음수 분산을 검사해 깨진 체크포인트를 거절합니다. 복원 범위는 추론용 weights·BN 통계까지이고 optimizer 상태를 포함한 학습 재개는 지원하지 않습니다. - 데이터는 내려받을 때 임시 파일에 쓴 뒤 원자적으로 옮기고, 항상 sha256을 대조합니다. 중간에 끊긴 파일이 캐시로 남아 이후 실행에서 계속 신뢰되는 일을 막습니다.
- 손그림 화면은 loopback에서만 실행합니다. 층이 forward 중간 상태를
self에 저장해 재진입할 수 없으므로 추론 구간 전체를 lock 하나로 직렬화합니다.
내 기여
3인 팀 과제였고, 팀 저장소에서 본인 커밋은 12개(2026-05-22 ~ 05-28, 머지 1개 포함)입니다. git log --author="woonyong" 316ac86^..6a7e451로 확인할 수 있습니다.
- 환경: Conda 환경 재현 구성과 안내(316ac86, 2ecc5e1).
- 구현: 계층 연산·손실·optimizer·학습 루프 정리·완성(5dcf5d6, 6개 파일 +180/−43), 출력층 gradient 계산 흐름 정리(0bcfa7b).
- 실험·보고서: 하이퍼파라미터·optimizer 비교, 과적합·학습률 진단 실험과 발표용 보고서(2e67daf ~ 6a7e451), 학습 문서 정리(5481372).
- 다른 팀원이 작성한 커밋(BatchNorm·optimizer·network 구현 등)은 본인 기여에 포함하지 않았습니다.
검증

make test(pytest 48개, 약 3초). 한 사례를 고정 seed로 못 박는 대신 무작위 shape·값 여러 벌에 대해 성질이 항상 성립하는지를 봅니다.- 미분이 맞는가: BatchNorm의 dx·dgamma·dbeta, BatchNorm 유무 양쪽의 전체 MLP gradient, Softmax+CrossEntropy 결합 gradient를 모두 유한 차분과 대조합니다.
- 불변식: BatchNorm 출력의 평균은 β·표준편차는 |γ|, Softmax 행 합은 1이고 상수 이동에 불변, 추론은 running 통계를 쓰되 갱신하지 않음, optimizer는 배열을 재바인딩하지 않음(층이 같은 객체를 참조하므로), 배치 추론과 1장 추론의 결과 동일, 전처리는 그린 위치·배경색에 불변이고 MNIST 20px 박스 규약을 지킴.
- 회귀: 같은 seed면 가중치가 비트 단위로 같음, Adam의 bias correction 누락 시 첫 스텝이 3.16배 커지는 것, 학습 전 BatchNorm 추론이 3162배 증폭되지 않는 것.
- 실패 경로: 데이터 sha256 불일치, 끊긴 다운로드가 캐시되지 않음, 손상된 체크포인트(nan·shape 불일치·음수 분산·미지원 format) 거절, 빈 입력·과대 입력 거절, 잘못된 HTTP 요청의 400/404.
- 통합·동시성: 실제 HTTP 서버를 띄워 10개 숫자를 동시에 보내 단일 스레드 결과와 같은지 확인하고, 서버가 추론을 실제로 직렬화하는지(lock을 빼면 실패) 검사합니다.
- 학습 루프도 테스트합니다: 합성 데이터로 MNIST 다운로드 없이 학습을 돌려 loss가 내려가는지, 저장되는 체크포인트가 validation 정확도가 가장 높았던 epoch의 것인지(이 저장소의 평가 주장 그 자체), 평가의 혼동행렬 합이 test 장수와 같은지 확인합니다.
- 커버리지 97%:
checkpoint·images·layers·losses·network·optimizers100%,application98%,training98%,data92%,serving81%(남은 부분은serve_forever블로킹 루프). - CI(ci.yml): ubuntu-latest에서
uv로 잠금 파일 그대로 설치하고make test를 실행합니다. 테스트는 MNIST 다운로드 없이 돕니다.
배운 점·한계
- 선택에 쓴 데이터로 성능을 말하면 낙관적입니다. 팀 시절에는 테스트 정확도로 설정을 골랐고, 이 저장소에서 validation 분리를 도입했습니다. 대신 정확도는 98.54% → 97.80%로 낮아졌지만 모델 구성도 달라서 이 차이를 분리해 측정하지는 않았습니다.
- 극단 조건 실험에서 은닉층 10개 MLP는 테스트 11.42%(무작위 수준)로 학습에 실패했고, 마지막 정확도만 보지 말고 loss 곡선을 함께 봐야 한다는 것을 배웠습니다(보고서 §5).
- 이미지 한 장에 숫자 하나를 입력하는 MLP입니다. 손그림은 굵기·위치 차이로 오분류할 수 있고, 점수는 보정된 confidence가 아닙니다.
- 병목은 행렬곱이 아니었습니다. batch를 아무리 키워도 같은 행렬곱만 돌린 하한이 전체 시간의 절반을 넘지 못합니다 — 남는 시간은 BatchNorm·ReLU·Softmax의 원소 연산과 NumPy 임시 배열입니다. 짐작하지 않고 재 보고 알았습니다(bench).
- 아직 틀린 것도 적어 뒀습니다: BatchNorm의 eps가 표준(1e-5)보다 작은 1e-7이고, Dropout이 inverted가 아닌 vanilla입니다. 둘 다 고치면 출하 모델이 달라져 다음 재학습 때로 미뤘습니다(설계 노트 3절).
출처
크래프톤 정글 팀 과제(원본: Jungle-12-303/wk13_6_mnist, 비공개)에서 시작했고, 종료 후 개인 저장소에서 계속 수정·학습·확장하고 있다.
- 과제 제공:
krafton-jungle/mnist-lab(팀 저장소는 이 과제의 사본에서 시작). - 기간: 2026-05-22 ~ 05-28 (팀 저장소 커밋 기준). 기준 revision
6a7e451(원본 개인 사본 woonyong-choi/SW_AI-W13-mnist에서 이어 받음). - 팀 구성: 3인. 본인 담당은 위 내 기여(커밋 12개 기준)입니다.
- 개인 확장: 2026-09-08 ~ 2026-09-22,
git log --author="woonyong" 6a7e451..HEAD. 팀 시절의 신경망 구현 위에 데이터 분리(train/validation/test), 모델 저장·복원(pickle 없음), 이미지 CLI와 손그림 화면, 수치 검증 테스트, CI를 추가했습니다. - 과제 설명과 이전 실험은 정리 전 이력에 남아 있습니다. 과제 제공물의 저작권 표시는 유지합니다.
이 페이지의 본문은 woonyong-choi/lrn-mnist 의 README(커밋 30439e9)를 그대로 옮긴 것입니다. 프로젝트 목록으로