빈 블록을 AVL 트리로 관리하는 할당기를 C로 만들고 first-fit free list와 비교했다.
- 역할
- 개인 과제 · 개인 구현 종료
- 기간
- 2026-04-10 ~ 2026-09-22
C로 직접 만든 동적 메모리 할당기입니다. 빈 블록을 AVL 트리(best-fit, O(log n))로 관리하는 구현과 first-fit 명시적 free list를 같은 trace에 넣어 정확성·이용률·처리량을 비교했습니다.
메모리 관리 Wiki · 설계 노트 · AVL 구현 · 비교용 free list
데모 (구동모습)
위 GIF는 bash scripts/demo_terminal.sh의 실제 실행입니다: trace 재생 중 블록 변화(short1-bal, AVL)와 7개 trace 검증·측정 결과를 보여 줍니다. 이용률은 결정적 값이라 아래 표와 같고, 처리량은 기계 부하에 따라 달라집니다.
make demo는 요청마다 힙 블록의 offset·크기·사용 여부를 출력합니다. 아래는 short1-bal.rep(AVL)의 실제 출력 앞부분입니다. 2040바이트 요청 2개가 채워진 뒤, free id=1로 두 번째 블록이 빈 블록이 되고, 48바이트 요청이 그 빈 블록을 쪼개 씁니다.
a id=0 request=2040 heap=4112
  offset=16 block=2048 used
  offset=2064 block=2048 free
a id=1 request=2040 heap=4112
  offset=16 block=2048 used
  offset=2064 block=2048 used
f id=1 request=0 heap=4112
  offset=16 block=2048 used
  offset=2064 block=2048 free
a id=2 request=48 heap=4112
  offset=16 block=2048 used
  offset=2064 block=56 used
  offset=2120 block=1992 free
문제와 목표
malloc은 free된 자리를 얼마나 빨리 찾고(처리량), 얼마나 덜 낭비하는가(이용률)의 균형입니다. 가장 단순한 first-fit free list는 빈 블록이 많아질수록 탐색과 free가 선형으로 느려집니다.
- 목표 1:
mm_init/malloc/free/realloc을 최대 20 MiB의 memlib 힙 위에서 8바이트 정렬·비중첩·데이터 보존을 지키며 구현한다. - 목표 2: 빈 블록 탐색을 O(log n)으로 줄이는 AVL 구현을 만들고, first-fit 구현과 같은 trace·같은 검증으로 비교한다.
- 목표 3: 그 차이가 자료구조 때문인지 다른 요인 때문인지 실험으로 가른다.
- 비목표: libc 대체, 멀티스레드,
LD_PRELOAD.
결과
두 구현 모두 7개 trace(대표 trace 6개 + seed 731 혼합 stress 1개)에서 실제 메모리에 패턴을 쓰고 비중첩·보존을 검증해 14/14 통과했습니다.1
| trace | 요청 수 | 이용률 AVL | 이용률 list | 처리량 AVL (M ops/s) | 처리량 list (M ops/s) | AVL 배수 |
|---|---|---|---|---|---|---|
| amptjp-bal | 5,694 | 99.2% | 88.4% | 39.7 | 2.0 | 20.0x |
| binary2-bal | 24,000 | 48.8% | 40.7% | 0.6 | 0.2 | 2.5x |
| coalescing-bal | 14,400 | 66.6% | 99.2% | 111.6 | 281.2 | 0.4x |
| random2-bal | 4,800 | 95.2% | 87.0% | 16.0 | 1.3 | 12.5x |
| realloc2-bal | 14,401 | 31.2% | 30.1% | 74.9 | 26.2 | 2.9x |
| short1-bal | 12 | 66.2% | 65.8% | 78.6 | 198.0 | 0.4x |
| stress (seed 731) | 3,041 | 88.1% | 70.2% | 14.2 | 17.3 | 0.8x |
- 이용률(= 최대 요청 payload / 최종 힙 크기)은 결정적 값입니다. AVL이 7개 중 6개에서 높고,
amptjp는 99.2%로 list보다 10.8%p 높습니다. - 처리량은 빈 블록이 쌓이는 trace에서 AVL이 크게 앞섭니다(
amptjp20배,random212.5배). 반대로 빈 블록이 한두 개뿐인coalescing·short1에서는 list가 2~3배 빠릅니다 — n이 작으면 O(log n)에 이점이 없고 노드 갱신 비용만 남습니다. - 처리량의 절대값은 믿지 말고 배수를 보세요. 노트북에서 같은 명령을 5회 돌렸을 때
amptjp의 AVL 절대값은 29.5~47.3 M ops/s로 흔들렸지만, list 대비 배수는 18.7~21.8x 안에 있었습니다. 표의 절대값은 5회 중앙값입니다. coalescing-bal의 이용률 차이는 자료구조 때문이 아닙니다. 힙 확장 정책 두 가지(초기 4 KiB 선확보, 확장 요청의 4 KiB 올림)를 끄면 같은 AVL 구현이 99.6%로 올라가 list(99.2%)를 넘어섭니다.make ablation으로 재현할 수 있고, 왜 기본값을 그대로 두었는지는 설계 노트 §3에 있습니다.
실행 방법
macOS/Linux의 C compiler, Make, Python 3가 필요합니다. 설치할 패키지는 없습니다.
make setup     # 빌드
make test      # 계약·실패 경로 + 무작위 불변식 테스트 + 7개 trace 검증
make bench     # 이용률·처리량 측정 → .build/results.json, docs/bench.svg
make ablation  # 힙 확장 정책 4조합 비교 → .build/ablation.json
make demo      # 블록 변화를 출력하는 데모 (AVL, list)

# 다른 trace를 직접 재생
.build/trace-avl malloc-lab/traces/random2-bal.rep
# 특정 seed의 불변식 테스트만 재현
.build/invariants-avl 731
설계
malloc → 빈 블록 탐색 → 분할 → (없으면) 힙 확장 → payload 포인터 반환, free → 이웃 병합 → 빈 블록 재등록으로 이어집니다. 선택의 근거와 버린 대안은 설계 노트에 있습니다.
AVL 구현 (mm.c)
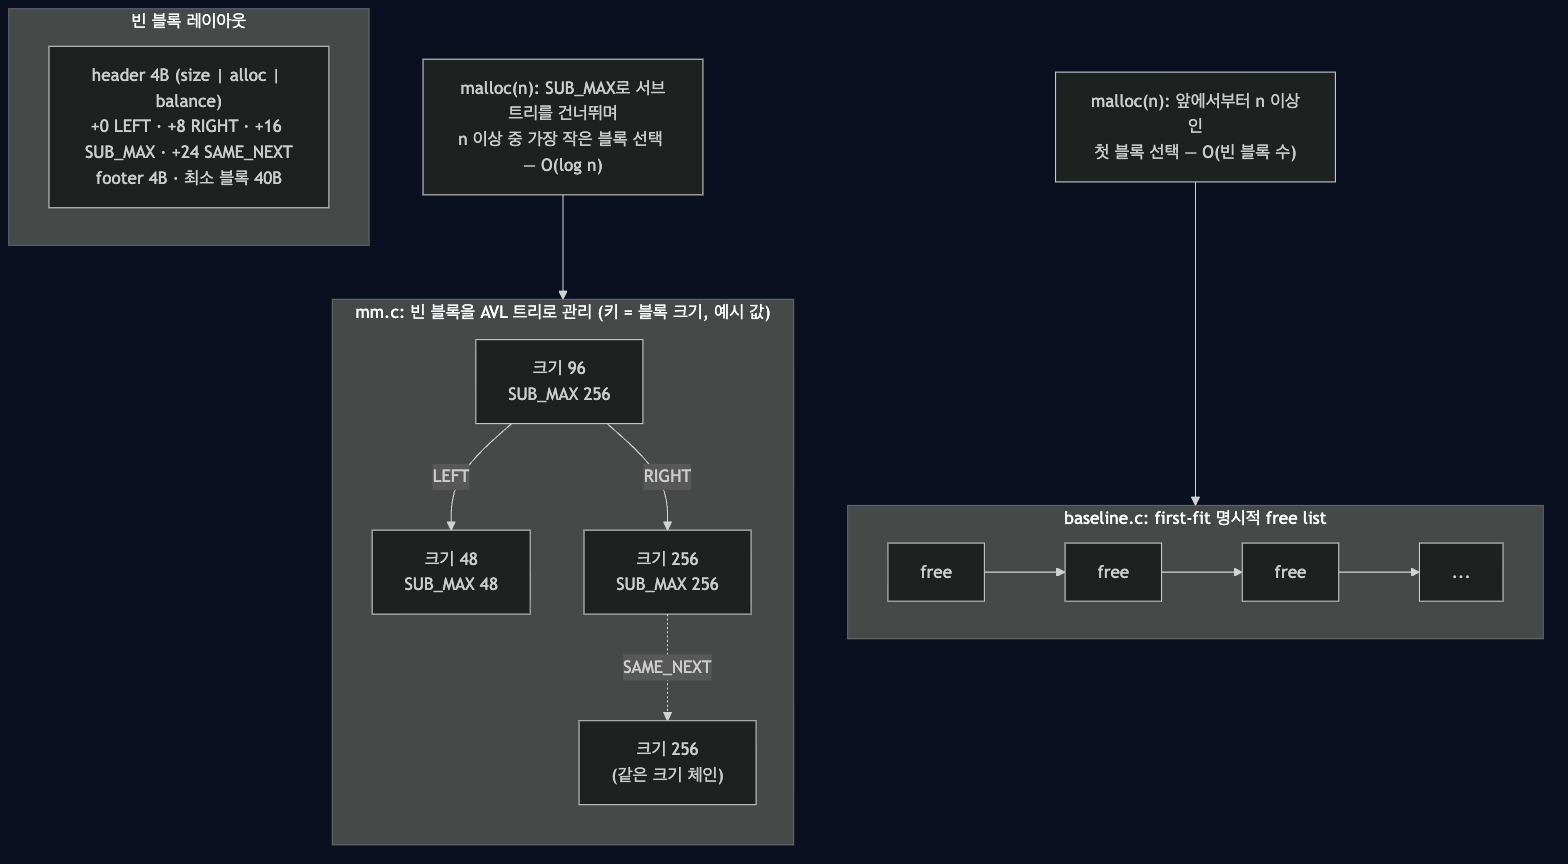
- 빈 블록을 크기를 키로 하는 AVL 트리에 넣습니다. 같은 크기의 블록은 노드에
SAME_NEXT로 이어 붙여 트리는 서로 다른 크기만 가집니다. - 각 노드는 자기 서브트리의 최대 빈 블록 크기(
SUB_MAX)를 가집니다. 요청보다SUB_MAX가 작은 서브트리는 통째로 건너뛰므로, “요청 이상 중 가장 작은 블록”(best-fit)을 O(log n)에 찾습니다. 회전·삽입·삭제 때마다SUB_MAX를 갱신합니다. - 헤더·푸터(boundary tag)로 이웃 블록을 O(1)에 찾아
free즉시 병합합니다.realloc은 축소 시 제자리에서 분할하고, 다음 블록이 비어 있으면 합쳐 제자리 확장합니다. - 트리 노드 정보(left·right·
SUB_MAX·SAME_NEXT, 각 8바이트)를 빈 블록의 payload에 저장해 사용 중인 블록의 오버헤드는 헤더·푸터 8바이트로 유지합니다. 대가로 최소 블록이 40바이트입니다. - 균형 인수는 별도 필드 없이 헤더의 남는 비트 1-2에 넣습니다. 블록 크기가 8의 배수라 하위 3비트가 비고, 비트 0은 이미 할당 여부가 쓰고 있습니다.
비교용 first-fit (baseline.c)
- LIFO 명시적 free list를 처음부터 훑어 처음 맞는 블록을 씁니다(first-fit). 탐색 O(n).
free는 이전 블록이 비었는지 보려고 블록 목록을 처음부터 순회합니다(O(n)).realloc은 항상 새로 할당하고 복사합니다.
왜 AVL과 best-fit인가
- first-fit 대비 병목은 “빈 블록이 많을 때의 선형 탐색”입니다. 트리는 탐색을 O(log n)으로 줄이고, best-fit은 남는 조각을 줄여 이용률에도 유리합니다.
amptjp·random2처럼 빈 블록이 많이 쌓이는 trace에서 이 효과가 처리량(12~20배)과 이용률(+8~11%p) 양쪽으로 나타났습니다. - 버린 대안(크기별 분리 free list, 레드블랙 트리)과 그 이유는 설계 노트 §2에 적었습니다.
- 계약: 0 크기
malloc은 NULL,free(NULL)은 no-op,realloc(NULL,n)은malloc,realloc(p,0)은free입니다. 표현 범위를 넘는 요청은 NULL로 거절하고 원래 payload를 보존합니다.
검증

trace를 재생해 답이 맞는지 보는 것만으로는 “AVL이 정말 AVL인가”를 알 수 없습니다. 균형이 무너져도, SUB_MAX가 어긋나도, 탐색이 best-fit이 아니어도 통과하기 때문입니다. 그래서 결과가 아니라 구조를 검사합니다.
- 불변식 속성 테스트: 무작위 연산열을 돌리며 매 연산 뒤
mm_checkheap()을 호출합니다 — 정렬·헤더푸터 일치·인접 빈 블록 미병합 없음, 그리고 BST 순서·높이차 ≤ 1·헤더에 저장된 균형 인수가 실제 높이차와 일치·SUB_MAX가 실제 서브트리 최대와 일치·트리 노드 수 == 빈 블록 수. 64 연산마다mm_check_bestfit()으로 탐색이 고른 블록이 선형 주사로 구한 “요청 이상 중 최소”와 같은지 대조합니다. - 검사기가 실제로 잡는지 확인했습니다. 회전 후
SUB_MAX미갱신, 재균형 생략, best-fit 대신 first-fit, 분할 잔여 블록 미등록, 병합 생략 — 다섯 가지 결함을 주입해 전부 검출했습니다(설계 노트 §4의 표). - 계약·실패 경로 테스트: NULL·0·표현 범위 초과, 그리고 20 MiB 힙 고갈 — malloc이 NULL을 돌려주고, 살아 있는 블록과 힙 불변식이 그대로이며, 하나를 해제하면 다시 할당할 수 있어야 합니다.
- trace 실행기: 실제 메모리에 패턴을 써서 비중첩·데이터 보존을 확인합니다.
- 같은 테스트를 두 구현에 모두 링크해 돌립니다. CI(ci.yml)는 ubuntu-latest에서
make setup·make test를 실행합니다.
배운 점·한계
- 자료구조를 바꾸면 “빠르다”만이 아니라 이용률·최소 블록·오버헤드가 함께 움직이고, trace마다 승자가 달라진다는 것을 측정으로 확인했습니다.
- 불리한 결과 하나를 끝까지 파는 게 가장 많이 남았습니다.
coalescing-bal에서 AVL이 지는 것을 한동안 “자료구조 때문인지 모르겠다”로 두었는데, 확장 정책을 컴파일 타임 손잡이로 빼서 4조합을 같은 trace에 돌리니 답이 나왔습니다: 트리는 무관하고, 살아 있는 payload가 8 KiB뿐인 trace에서 미리 잡은 4 KiB가 힙의 3분의 1이었습니다. 끄면 99.6%로 list를 넘어섭니다. 다만stress·realloc2에서는 손해라 기본값은 두었습니다 — 이제 그건 모름이 아니라 선택입니다. - 가장 큰 남은 병목은 최소 블록 40바이트입니다. 작은 요청이 많은
binary2의 이용률 48.8%가 주로 여기서 나옵니다. 작은 크기만 크기별 분리 list로 빼는 것이 다음 수입니다. - 단일 스레드 교육용 할당기입니다. 유효한 pointer의
free/realloc만 계약에 포함하며 double free·임의 pointer는 undefined behavior입니다. 한계 전체는 설계 노트 §5에 있습니다.
출처
크래프톤 정글 개인 과제(원본: woonyong-choi/SW_AI-W07-malloc-lab, 비공개)에서 시작했고, 종료 후 개인 저장소에서 계속 수정·학습·확장하고 있다.
- 원본 기간: 2026-04-10 ~ 2026-04-20 (원본 첫·마지막 커밋일). 기준 revision
22c69e6. - 개인 확장: 2026-09-08 ~ 2026-09-22,
git log --author="woonyong" 22c69e6..HEAD. 원본에는 AVL 할당기와 과제 제공 mdriver 환경이 있었고, 이후 first-fit 비교 구현·trace 실행기·불변식 검사·확장 정책 ablation·이 README를 추가했습니다. - 과제 자료와 기존 할당 전략의 기록은 정리 전 이력에 있습니다. 과제 제공 코드의 저작권 표시는 소스에 유지합니다.
-
재현:
make bench→ 원본은.build/results.json. 측정 환경은 Apple M4 / Apple clang 17.0.0 /-O2이고, 처리량은 trace 해석·검증 시간을 제외한 재생만 20회 표본으로 재서 가장 빠른 표본을 씁니다(평균도ops_per_second_mean, 둘의 차이도spread_pct로 함께 기록). 표의 처리량은make bench5회의 중앙값, 이용률은 1회 값입니다(결정적이라 반복해도 같습니다). ↩
이 페이지의 본문은 woonyong-choi/lrn-malloc 의 README(커밋 19b8479)를 그대로 옮긴 것입니다. 프로젝트 목록으로