byte-level BPE와 decoder Transformer를 직접 구현해 학습·재개·생성까지 이었다.
- 역할
- 팀 과제 · 개인 확장 진행 중
- 기간
- 2026-05-14 ~ 2026-09-22
GPT가 글자를 토큰으로 쪼개고 다음 토큰을 배우는 전 과정을 이해하려고, byte-level BPE와 작은 decoder Transformer를 직접 구현해 학습·재개·생성까지 이어 붙인 프로그램입니다. PyTorch는 텐서 연산과 자동 미분에만 사용합니다.
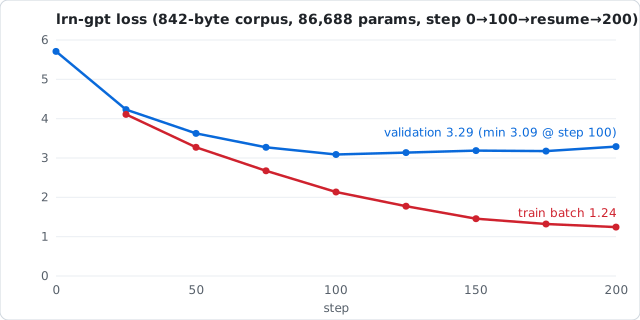
버전업된 모습
결과: 테스트 23개 통과 · 검증 loss 5.71 → 3.09(step 100) → 3.29(step 200) · BPE 학습 약 4배 빠름(merge·encode 결과 동일) — 수치와 재현 명령은 검증, 설계 근거는 docs/design.md.
팀 시기(cf42373)에는 실험 러너 9개, 감성 분류 헤드, NSMC 대량 탐색, 학습 예제 스크립트가 흩어져 있었습니다. 이 저장소에서는 이를 정리하고 “BPE 학습 → Transformer 학습 → checkpoint → 재개 → 생성”이 한 CLI(runnable.py)로 끝나는 경로만 남겼습니다. 데이터 다운로드 없이 make demo로 학습 전·후 모델의 생성 결과를 바로 비교할 수 있습니다.
| 항목 | 팀 시기 (cf42373) | 현재 | 재현 |
|---|---|---|---|
| 진입점 | scripts/run_*.py 9개 + 학습 스크립트 다수 | src/runnable.py 하나 (train·generate·demo) | git diff --name-status cf42373..4c066ec -- scripts src |
| BPE 학습 시간 | 4.81 s | 1.13 s (약 4.3배, merge 340개·encode 결과 동일) | make bench |
| 테스트 | 모듈별 테스트 다수 | 23개 (BPE property 포함, 커버리지 82%) | make test |
| 코드 변화 | — | 208 files, +564 / −28,201 | git diff --shortstat cf42373..4c066ec |
BPE 시간은 78.7 KB 고정 코퍼스(cf42373 리비전의 소스·README, sha256 기록), vocab 600 기준입니다. 두 구현을 번갈아 7회 측정한 최솟값이며, 독립 실행 3회에서 4.29 / 3.77 / 4.27배였습니다. 처음에는 한 구현씩 몰아서 재다가 같은 머신에서 배율이 3.5~6.8배로 흔들렸습니다 — 머신 부하 변화가 나중에 잰 쪽에만 얹혔기 때문이고, 그래서 지금은 교차 측정합니다. 전체 수치는 docs/bench-bpe.json.
어려웠던 점. BPE는 규칙이 단순한 만큼 “같은 코퍼스는 항상 같은 결과”를 보장하는 세부가 어려웠습니다. 빈도가 같은 pair, aaaaa처럼 겹치는 pair를 어떻게 병합할지 정하지 않으면 실행마다 vocabulary가 달라지고, 그러면 checkpoint를 재개할 때 토큰 ID가 어긋납니다. 재개도 마찬가지로, optimizer·난수 상태·설정·tokenizer·corpus hash를 함께 저장해야 dropout이 있어도 학습 궤적이 이어집니다(데이터가 바뀐 재개는 거절).
솔직한 한계도 있습니다. 코퍼스가 842바이트뿐이라 검증 loss는 step 100에서 최저(3.09)를 찍고 그 뒤 올라갑니다 — 과적합 시연이지 쓸 만한 생성 모델이 아닙니다. 팀 시기의 감성 분류·NSMC 실험은 이 경로에 포함하지 않았고 정리 전 이력에만 있습니다.
구동모습
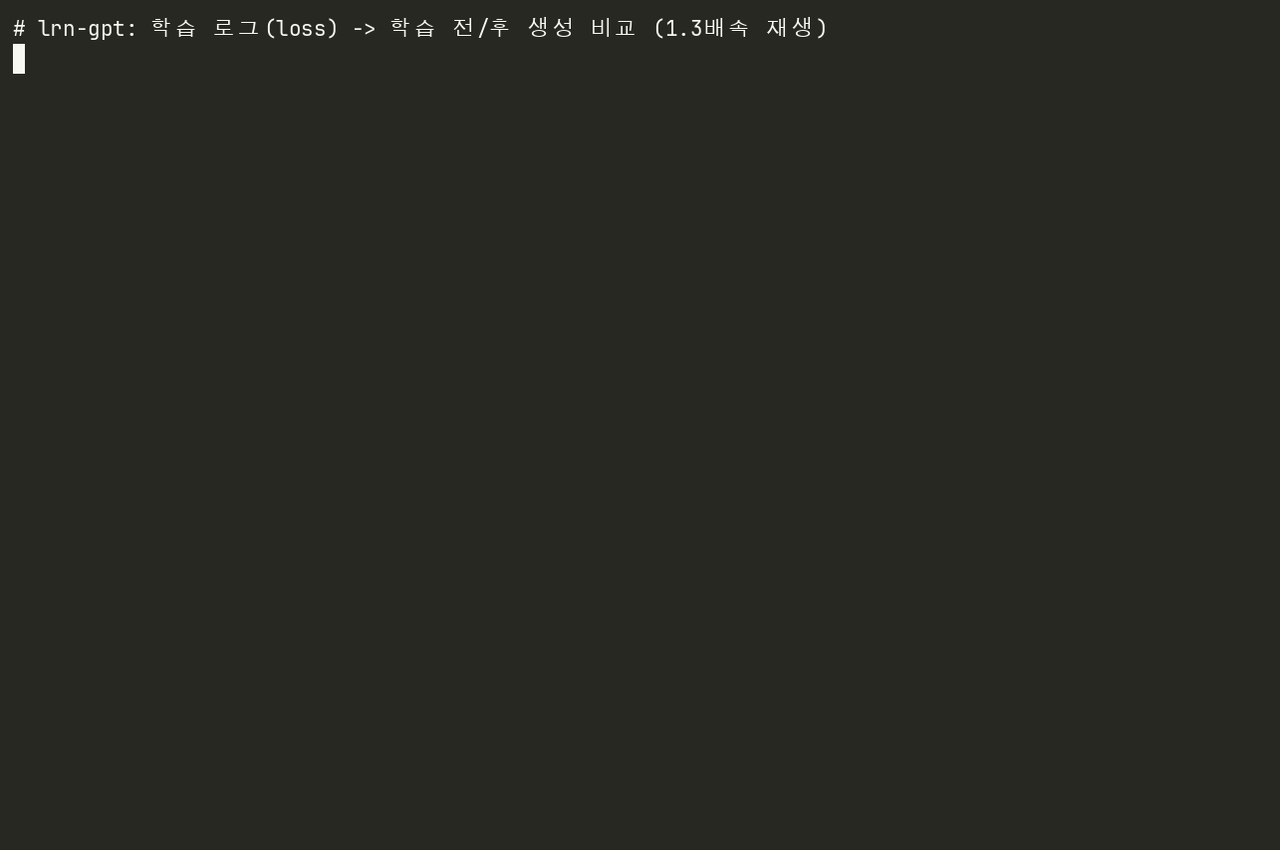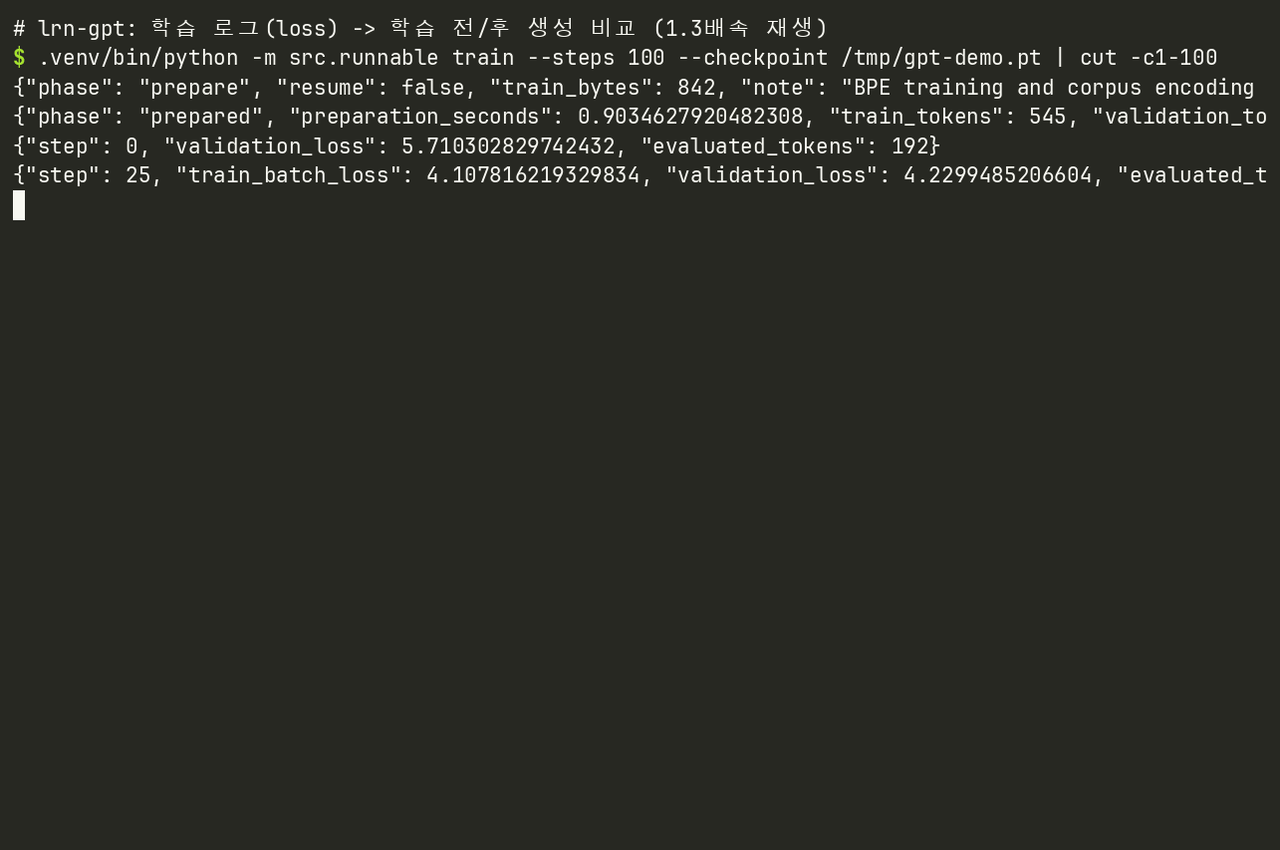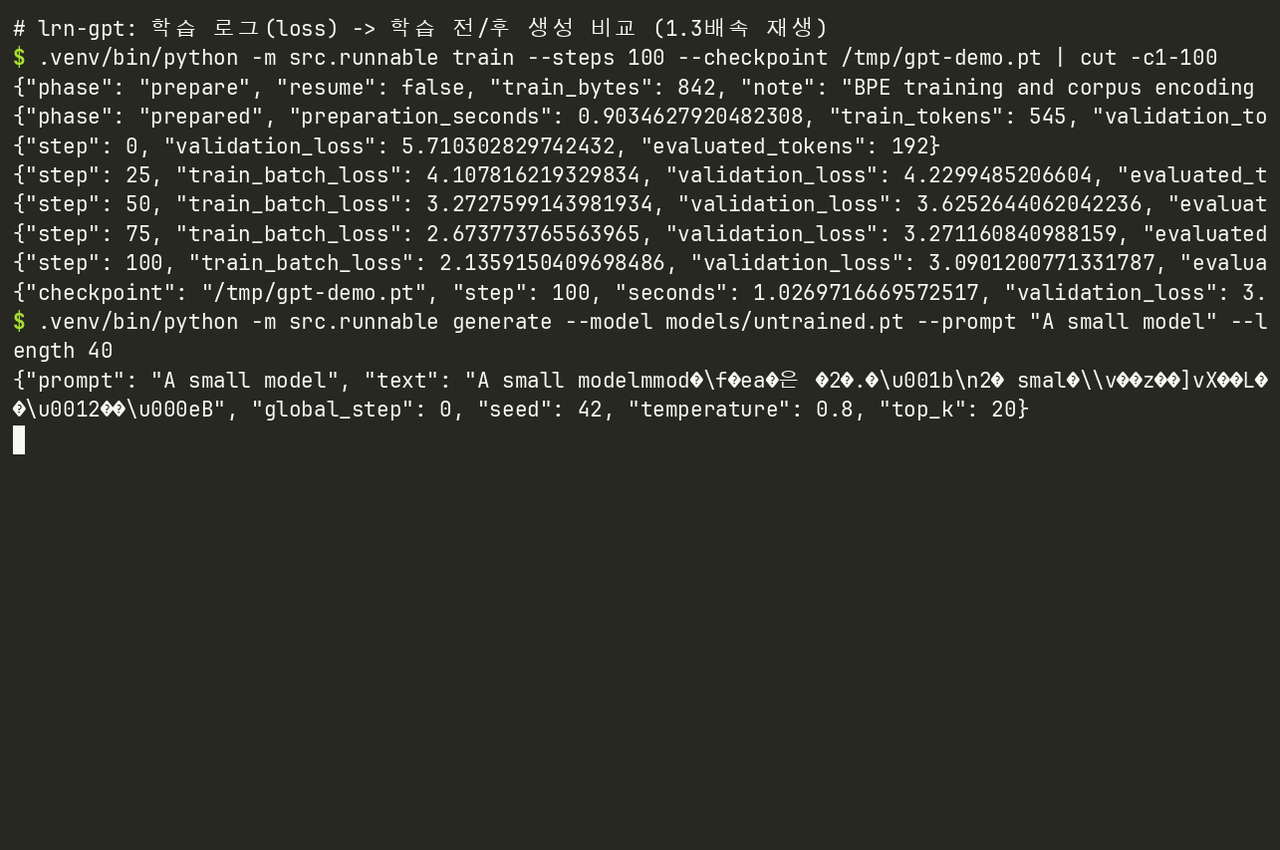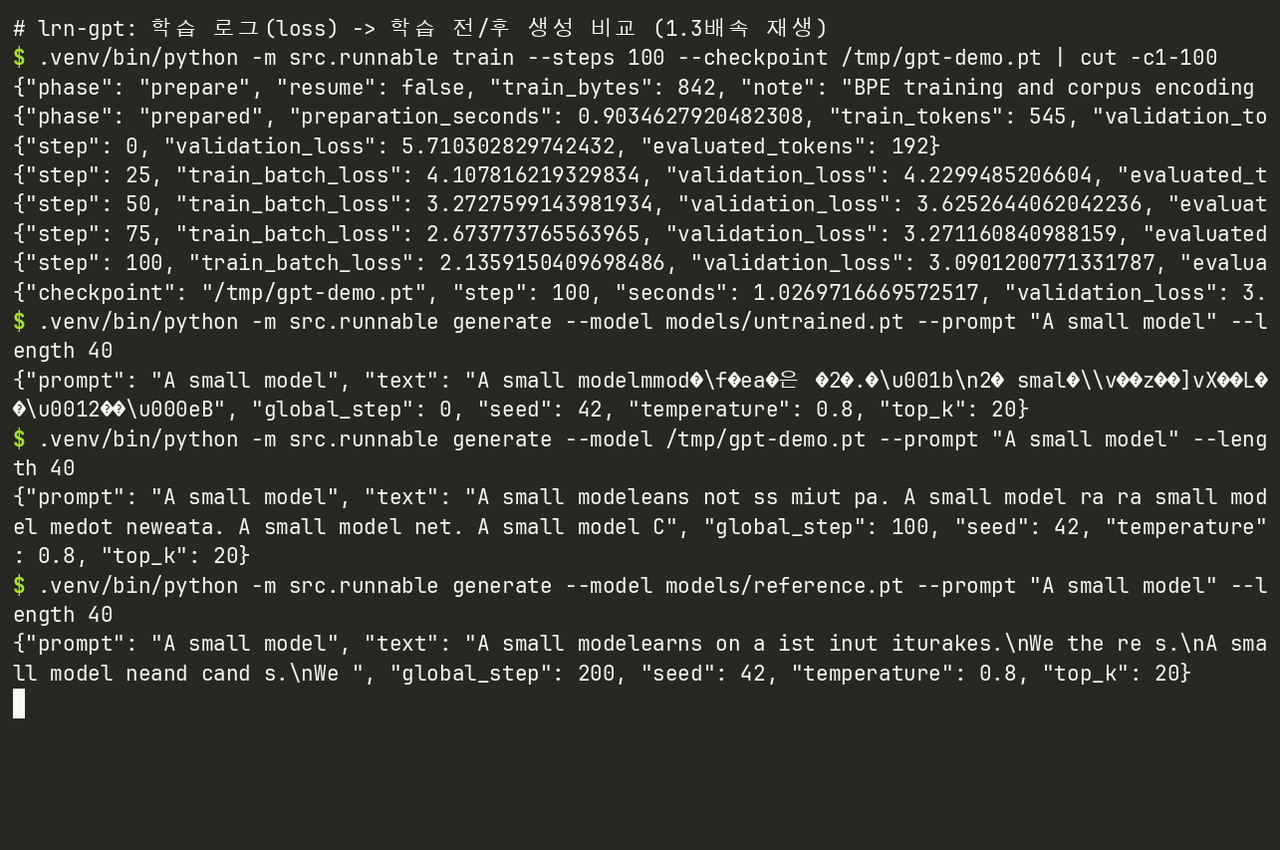
bash scripts/demo_terminal.sh의 실제 실행입니다(1.3배속 재생). 100 step 학습 로그에서 검증 loss가 5.71 → 3.09로 내려가고, 같은 prompt A small model과 seed 42로 학습 전(step 0)·방금 학습한 모델(step 100)·제공 모델(step 200)의 생성을 비교합니다. 생성은 결과를 한 번에 출력하며 토큰 단위 스트리밍은 지원하지 않습니다.
make demo는 같은 prompt A small model을 학습 전(step 0)·후(step 200) 모델에 넣습니다. 실제 출력입니다(byte-level이라 학습 전 출력에는 제어 문자와 깨진 UTF-8이 섞입니다).
| 모델 | temperature / top-k | 생성 결과 |
|---|---|---|
| 학습 전 (step 0) | 0.5 / 5 | A small model + 임의 바이트열(제어 문자·� 포함) |
| 학습 후 (step 200) | 0.5 / 5 | A small modelearns fromistttttuent ita small model on a small model on a sepataire om se |
| 학습 후 (step 200) | 1.0 / 20 | A small modelearncan� tut inut token. We ve the ve me the ve sutimalizere m se |
학습 후에도 문장은 되지 않지만 코퍼스의 단어 조각(small model, token, learns)이 나타납니다. 이것이 이 모델이 보여 주는 전부이며, 그 이상의 품질은 주장하지 않습니다.
메인 기술
UTF-8 텍스트 → BPE → 입력·정답 토큰 쌍 → causal attention·Transformer → loss/backward → checkpoint → sampling 순서입니다. 스택 나열이 아니라 직접 구현한 기법입니다. 왜 이 구조인지, 어떤 대안을 왜 버렸는지는 docs/design.md에 정리했습니다.
- byte-level BPE — 설계 결정은 아래에 따로 정리했습니다. bpe.py · test_bpe.py
- causal self-attention — 미래 토큰을 가리는 mask, 다중 head. head 루프 참조 구현과 PyTorch
scaled_dot_product_attention양쪽에 대조합니다. attention.py · test_attention.py - decoder Transformer — token·position embedding, residual, pre/post-normalization(
norm_first), GELU feed-forward. model.py · embeddings.py - 재개 가능한 학습 루프 — model·optimizer·step·설정·tokenizer·난수 상태·corpus hash를 checkpoint에 저장하고, 저장은 임시 파일 →
fsync→rename으로 원자적입니다. Ctrl-C에서도 현재 checkpoint를 남깁니다. runnable.py - temperature·top-k sampling — seed 고정 생성. generation.py
- 입력 검증 guard — 잘못된 shape·설정은 조기에 실패시킵니다. guards.py
BPE 설계 결정
| 결정 | 이유 · 대가 |
|---|---|
| UTF-8 바이트를 기본 토큰으로 (ID 0–3 special, 4–259 byte, 260~ merge) | 어떤 문자열도 <unk> 없이 표현되고 한글 같은 멀티바이트도 그대로 처리합니다. 대가: 문자보다 시퀀스가 길고, 생성이 UTF-8이 아닌 바이트 조합을 내면 �로 보입니다. |
| 결정적 tie-break — 빈도 → 최초 등장 위치 → token ID | 같은 코퍼스는 항상 같은 merge 목록을 만들어, 재개 시 vocabulary가 어긋나지 않습니다. |
겹치는 pair는 왼쪽부터 겹치지 않게 (aaaaa → 0·2번째만 병합) | 병합 결과를 유일하게 정의합니다. _replace_pair |
멈춤 조건 3가지 — 목표 vocab_size 도달 / 더 이상 pair 없음 / 최대 빈도 < min_frequency | 작은 코퍼스에서 의미 없는 1회 pair를 병합하지 않도록 합니다. 예제 설정은 vocab_size=300(merge 40개). |
| decode는 byte를 모아 마지막에 한 번만 UTF-8 해석 | 문자 중간의 바이트를 하나씩 decode하면 깨집니다. |
pair 카운트를 NumPy로 — 두 ID를 한 정수로 packing해 np.unique | 팀 시기 구현 대비 학습 약 4배 빠르고 merge·encode 결과는 동일합니다. 대가: 병합마다 전체 시퀀스를 다시 훑어 코퍼스가 2배면 시간은 2배보다 더 듭니다(21 KB 0.41 s → 157 KB 3.20 s). NSMC 규모의 다음 병목입니다. |
계획
- 코퍼스를 늘려 학습하면(
make data+make train-nsmc) 검증 loss의 최저점이 100 step보다 뒤로 밀리는지 확인하고, 그 로그와 곡선을docs/에 추가한다. - NSMC 규모에서 BPE 준비 시간이 병목으로 확인되면, 병합마다 전체를 재계산하는 대신 pair 빈도를 증분 갱신하는 방식으로 바꾸고
make bench의 동일성 검사(merge 목록·encode 결과)로 회귀가 없는지 확인한다. - byte-level 생성의 깨진 UTF-8이 불편하면, 생성 끝을 유효한 UTF-8 경계에서 자르는 옵션을 추가한다.
- 분류 헤드가 다시 필요해지면, 정리 전 이력의 감성 분류 구현을 현재 checkpoint 계약에 맞춰 옮긴다.
링크
- Transformer Wiki — 개념 정리
- 모델과 측정 결과 (manifest) — 설정·해시·검증 loss·환경
- 배포된 데모 URL은 없습니다(로컬 실행 전용).
담당
크래프톤 정글 팀 과제(원본: Jungle-12-303/wk13_6_gpt, 비공개)에서 시작했고, 종료 후 개인 저장소에서 계속 수정·학습·확장하고 있다.
| 구분 | 내용 |
|---|---|
| 원본 저장소 | Jungle-12-303/wk13_6_gpt (비공개). 과제 제공물은 krafton-jungle/gpt-lab(현재 접근 불가), 중간 개인 저장소는 woonyong-choi/SW_AI-W13-gpt(비공개). 파생 기준 revision cf42373 |
| 기간 | 2026-05-14(과제 제공 커밋) ~ 2026-06-04(팀 저장소 마지막 커밋) |
| 팀 구성 | GitHub contributors 기준 4개 계정(본인 + 팀원 2명 + 과제 제공 계정 1) |
| 팀 시기 본인 담당 | Transformer 블록·attention, loss·checkpoint·생성 유틸, 사전학습 루프, 감성 분류 헤드와 학습 루프, 실험 러너·NSMC 실험, BPE 구현 통합 — 커밋 기준 본인 65 / 팀원 17 / 과제 제공 1. 팀원은 BPETokenizer의 encode·decode와 train·save·load, 실험 보고서를 작성 |
| 개인 확장 | b283d41(2026-09-08) ~ 최근, 개인 커밋 — 학습·재개·생성 경로 완성(runnable.py), BPE 처리 개선(약 4배), 실험 코드·보고서 정리, NSMC 준비 비용과 검증 범위 기록, CI·README 정리 |
개인 확장 범위 확인: git log --author='choi woo-nyong' --oneline cf42373..HEAD. 과제 제공물·팀 구현·이후 확장은 Git author와 diff로 구분하며 기존 저작권 표시는 유지합니다.
구동방법
Python 3.12와 uv가 필요합니다. 의존성은 requirements.lock으로 고정합니다.
make setup      # .venv 생성 + 고정 의존성 설치
make demo       # 포함된 학습 전·후 모델로 생성 비교 (데이터 다운로드·새 학습 불필요)
make test       # pytest (23개, 약 6 s)
make bench      # BPE 속도·결과 동일성 비교 -> docs/bench-bpe.json (git 이력 필요)
직접 학습하고 재개하려면 (--steps는 추가 횟수가 아니라 최종 step입니다):
.venv/bin/python -m src.runnable train --steps 100 --checkpoint .artifacts/run.pt
.venv/bin/python -m src.runnable train --resume .artifacts/run.pt --steps 200 --checkpoint .artifacts/run.pt
.venv/bin/python -m src.runnable generate --model .artifacts/run.pt --prompt 'A small model' --temperature 0.8 --top-k 20 --length 60
# NSMC 데이터 준비와 학습은 별도 실행 (다운로드·BPE 준비 비용이 큼)
make data && make train-nsmc
학습 중 Ctrl-C는 현재 checkpoint를 저장하고, 강제 종료는 마지막 저장 지점까지 복구합니다. 초기 BPE 준비 중에는 checkpoint가 아직 없습니다.
스펙
| 항목 | 내용 |
|---|---|
| 언어·런타임 | Python 3.12 (측정 환경 3.12.12) |
| 주요 라이브러리 | PyTorch 2.14.0(CPU, 텐서 연산·autograd 전용), NumPy · pytest |
| 모델 | 파라미터 86,688개 — vocab 300, context 32, emb 48, head 4, layer 2, dropout 0.1, pre-norm |
| 학습 설정 | batch 8, lr 0.002, seed 42, CPU. 코퍼스 examples/train.txt 842 B / validation.txt 323 B |
| 측정 환경 | Apple M4 · macOS · 2026-09-08 기록 (manifest) |
| 범위 밖 | 범용 챗봇·분산 학습·RLHF·RAG. 같은 CPU 환경의 재개를 검증했으며 버전·하드웨어가 다른 실행의 bitwise 일치는 보장하지 않음. checkpoint는 weights_only=True로 읽으며 이전 노트북 형식과 자동 호환하지 않음 |
검증

| 항목 | 결과 | 재현 |
|---|---|---|
| 테스트 | 23 passed (BPE 7 · attention 8 · 학습·재개 8, 약 6 s). src/ 커버리지 82% | make test |
| 검증 loss (step 0 / 100 / 200) | 5.7103 / 3.0901 / 3.2903 — 재학습한 값이 manifest와 소수점까지 일치 | 위 구동방법의 학습·재개 명령, 로그 train-log.jsonl |
| BPE 학습 시간 | 4.81 s → 1.13 s (4.27배), merge 340개·encode 동일 | make bench (git 이력 필요) → docs/bench-bpe.json |
| 직접 구현 attention | head 루프 참조 구현·PyTorch SDPA 와 동일 출력 | make test → test_attention.py |
| 재개 정확성 | 3 step 연속 학습 == 1 step + 저장·로드 + 2 step, rtol=0 atol=0 | make test → test_runnable.py |
학습 로그(docs/train-log.jsonl)에서 뽑은 곡선 수치입니다. “train batch”는 해당 step 한 mini-batch의 loss라 흔들릴 수 있고, 검증 loss는 192토큰 기준입니다.
| step | 0 | 25 | 50 | 75 | 100 | 125 | 150 | 175 | 200 |
|---|---|---|---|---|---|---|---|---|---|
| 검증 loss | 5.71 | 4.23 | 3.63 | 3.27 | 3.09 | 3.14 | 3.19 | 3.17 | 3.29 |
| train batch loss | — | 4.11 | 3.27 | 2.67 | 2.14 | 1.77 | 1.46 | 1.32 | 1.24 |
곡선 이미지 재생성: python scripts/plot_loss.py (plot_loss.py, 표준 라이브러리만 사용).
참고
- 원본:
Jungle-12-303/wk13_6_gpt(비공개), 과제 제공krafton-jungle/gpt-lab(접근 불가) - Transformer Wiki
- NSMC 원본 데이터: e9t/nsmc
- 정리 전 이력:
7875b64
이 페이지의 본문은 woonyong-choi/lrn-gpt 의 README(커밋 efe8050)를 그대로 옮긴 것입니다. 프로젝트 목록으로